Sommaire
En bref
- Qwen4-Max a été annoncé le 16 novembre 2026. Il n’est proposé qu’en ligne, sur QwenCloud et dans les applications de Qwen, et aucun poids Qwen 4 officiel n’est téléchargeable.
- L’équipe Qwen annonce des modèles Qwen 4 plus petits en open source, sans date ni taille.
- En local, Ollama propose
qwen3.8(27B, 18 Go en version par défaut) etqwen3.8-flash-next(125B, de 105 à 360 Go selon la version).- Dernière version d’Ollama : 0.40.16, publiée le 9 novembre 2026.
- Pour un agent de code comme Claude Code ou Codex, Ollama recommande un contexte d’au moins 64 000 jetons. Ce contexte demande de la mémoire en plus du modèle.
Qwen 4 peut-il tourner en local aujourd’hui ?
Non, pas encore. Le 16 novembre 2026, l’équipe Qwen d’Alibaba a publié l’annonce de Qwen4-Max, premier modèle de la famille Qwen 4. Selon cette annonce, il repose sur 2 400 milliards de paramètres, dont 71 milliards actifs par jeton, avec une fenêtre de contexte d’un million de jetons.
Il est proposé sur QwenCloud par abonnement (Token Plan) ou par API, et dans les applications QwenWork, Qoder et QwenStudio. Aucun fichier de poids n’est distribué.
La même annonce précise que des modèles plus petits de la famille « arrivent en open source », sans date ni liste de tailles. Au 20 novembre 2026, l’organisation Qwen n’a publié aucun modèle Qwen 4 sur Hugging Face. La bibliothèque d’Ollama n’a pas non plus de page qwen4.
Attention aux dépôts qui portent déjà ce nom. Une recherche « Qwen4 » sur Hugging Face renvoie par exemple des dépôts « Qwen4-27B » en NVFP4, en GGUF ou en AWQ. Ils sont publiés par des comptes tiers, pas par l’organisation Qwen. Tant que l’éditeur n’a rien publié, rien ne garantit ce qu’ils contiennent.
Quels modèles Qwen faire tourner en local, et sur quelle machine ?
En attendant les petits Qwen 4, deux familles récentes sont disponibles dans Ollama. Qwen3.8-27B est un modèle dense de 27 milliards de paramètres, publié sous licence Apache 2.0.
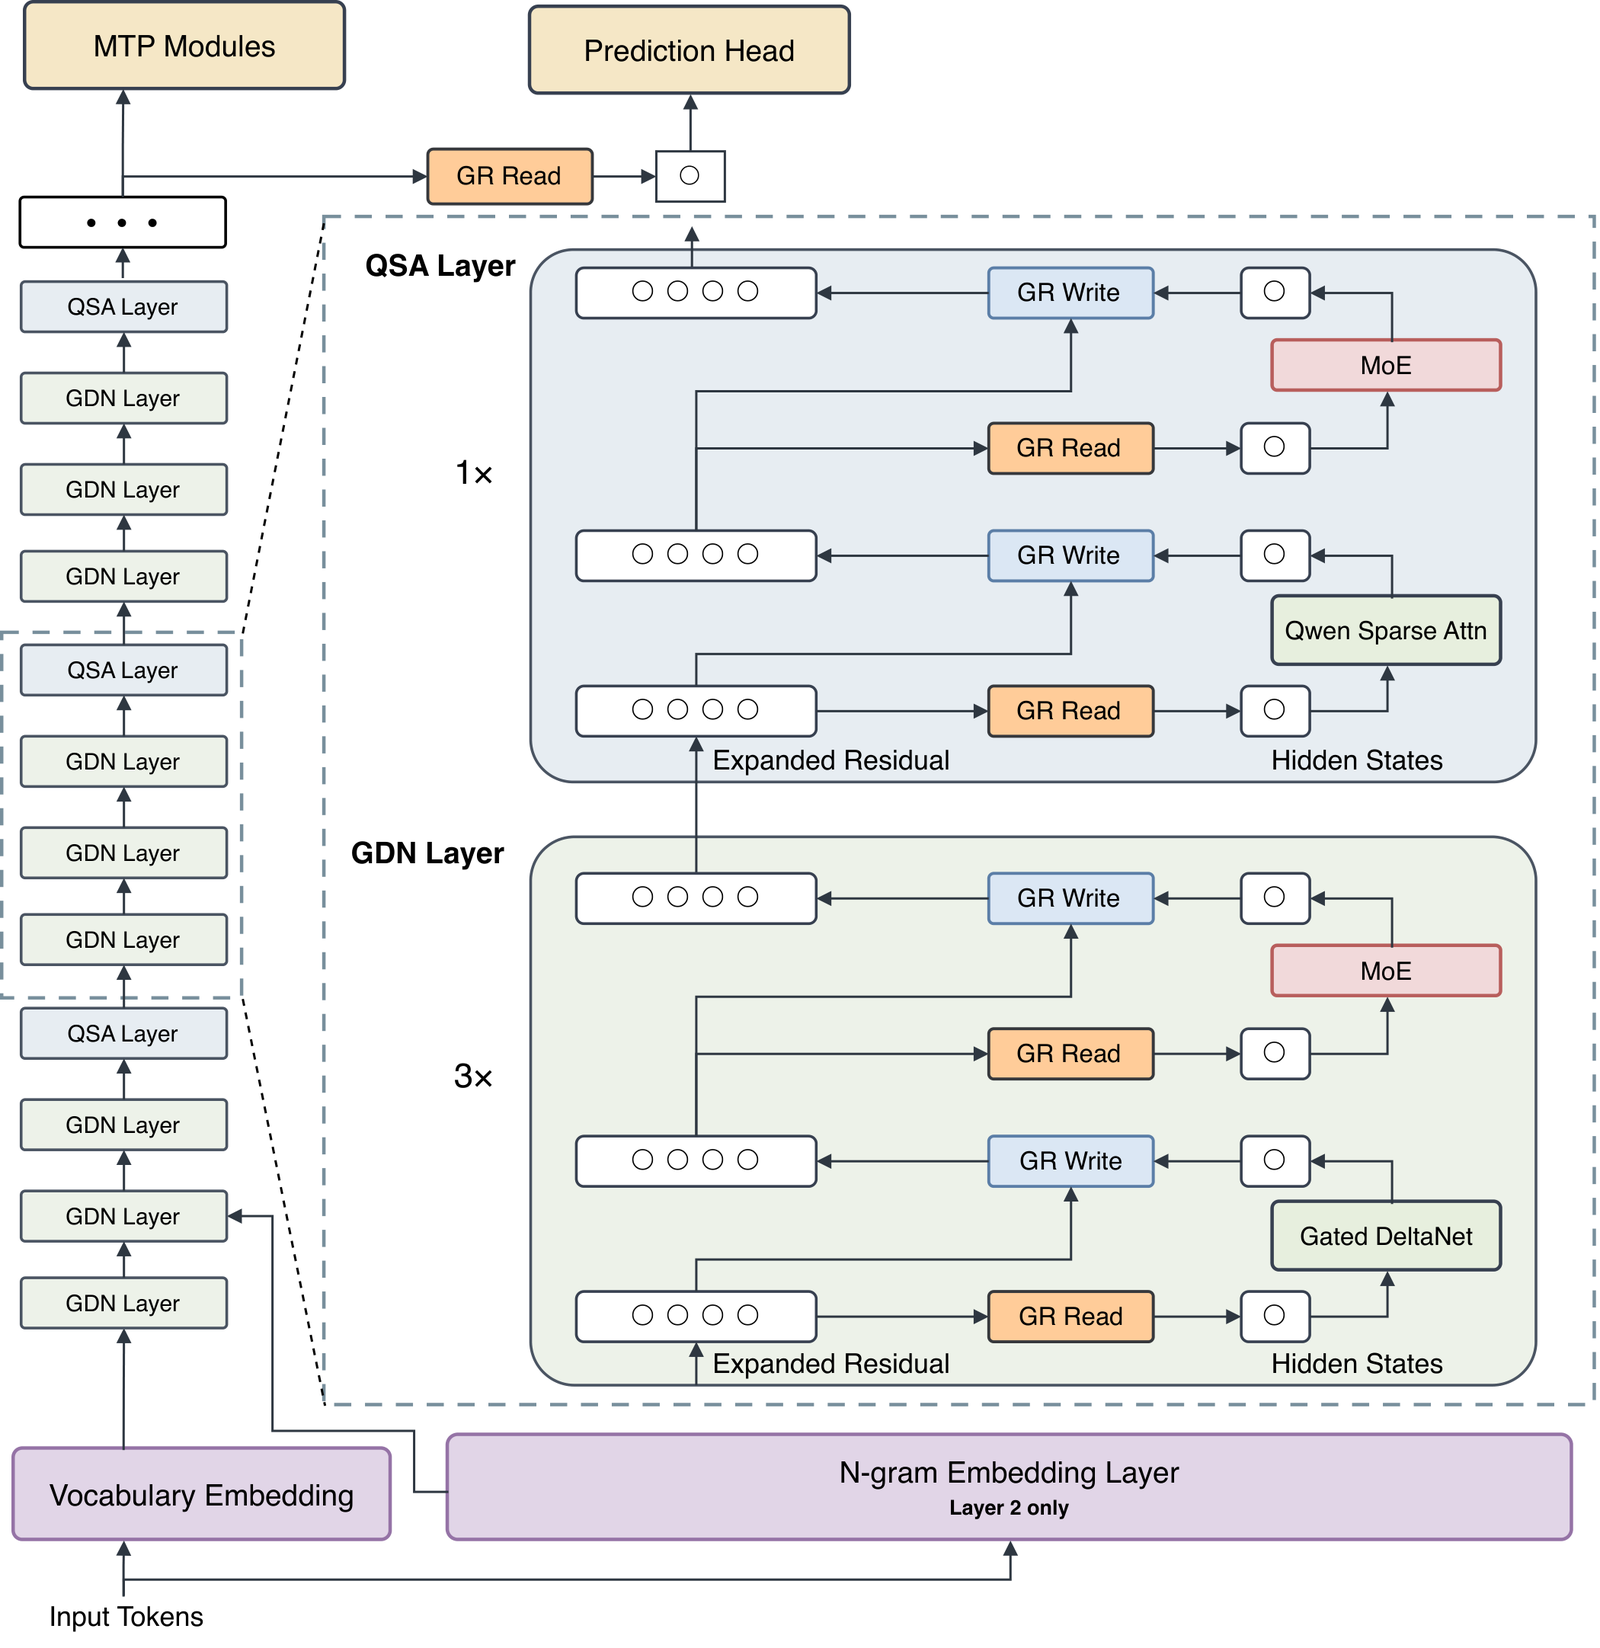
Qwen3.8-Flash-Next est un modèle à experts (MoE) de 125 milliards de paramètres. Selon sa fiche, il n’en active que 6 milliards par jeton et s’accompagne de 51 milliards de paramètres d’« n-gram embedding ». L’équipe Qwen le présente comme un « aperçu expérimental de l’architecture qui servira de base à Qwen4 ».
La même fiche décrit une alternance de trois couches Gated DeltaNet pour une couche Qwen Sparse Attention, ainsi que des résidus à portes. Le schéma publié avec Qwen4-Max reprend ces mêmes briques.
Le tableau reprend les tailles affichées par la bibliothèque Ollama. Ces chiffres correspondent au poids des fichiers téléchargés. Il faut ensuite de la mémoire en plus pour le contexte.
| Modèle Ollama | Taille du fichier | Contexte maximal | Licence |
|---|---|---|---|
qwen3.8 (27b, version par défaut) |
18 Go | 256K | Apache 2.0 |
qwen3.8:27b-q8_0 |
30 Go | 256K | Apache 2.0 |
qwen3.8:27b-bf16 |
56 Go | 256K | Apache 2.0 |
qwen3.8-flash-next:125b-mlx (MLX) |
105 Go | 256K | Qwen Community License 1.0 |
qwen3.8-flash-next:125b-a6b-q4_K_M |
120 Go | 256K | Qwen Community License 1.0 |
qwen3.8-flash-next:125b-a6b-q8_0 |
189 Go | 256K | Qwen Community License 1.0 |
Selon la FAQ d’Ollama, un modèle qui ne tient pas entièrement en mémoire graphique est réparti entre le GPU et la mémoire système. La commande ollama ps affiche alors un partage du type 48%/52% CPU/GPU.
Sur le papier, les 18 Go de qwen3.8 laissent environ 6 Go de marge sur une carte graphique de 24 Go pour le contexte. C’est un calcul, pas une garantie : un cas documenté à 24 Go, présenté plus bas, est déjà à la limite. Sur un Mac, la mémoire est unifiée : le système, les applications et le modèle se partagent la même enveloppe. Les versions de Flash-Next pèsent au moins 105 Go : elles visent des machines dont la mémoire dépasse largement ce volume.
Installer Ollama sur Linux, macOS et Windows
La dernière version d’Ollama est la 0.40.16, publiée le 9 novembre 2026. D’après ses notes de version, Qwen3.8-Flash-Next y consomme environ 27 Gio de mémoire en moins sur Apple silicon.
Sur Linux, la documentation donne une seule commande :
curl -fsSL https://ollama.com/install.sh | sh
Une installation manuelle est aussi documentée, avec une archive ollama-linux-amd64.tar.zst à extraire dans /usr. Vérifiez ensuite la version installée :
ollama -v
Sur macOS, il faut Sonoma (version 14) ou plus récent. Les puces Apple de la série M utilisent le CPU et le GPU, les Mac Intel le CPU seulement. Téléchargez l’image disque sur ollama.com/download et glissez l’application dans le dossier Applications.
Sur Windows, l’installateur OllamaSetup.exe s’installe dans votre compte sans droits administrateur. Il faut Windows 10 22H2 ou plus récent, ainsi que les pilotes NVIDIA 551.61 ou plus récents pour une carte NVIDIA. Les modèles sont rangés dans votre dossier personnel : prévoyez la place, ou définissez la variable OLLAMA_MODELS pour choisir un autre disque.
Lancer Ollama avec Docker
L’image officielle ollama/ollama fait tourner Ollama dans un conteneur, sans l’installer sur l’hôte. Sans GPU, la documentation donne cette commande :
docker run -d -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama
Avec une carte NVIDIA, installez d’abord le NVIDIA Container Toolkit, configurez Docker avec sudo nvidia-ctk runtime configure --runtime=docker, puis ajoutez --gpus=all :
docker run -d --gpus=all -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama
Pour une carte AMD, utilisez l’étiquette rocm et transmettez les périphériques /dev/kfd et /dev/dri. L’option -v ollama:/root/.ollama range les modèles téléchargés dans un volume Docker nommé ollama. Vous pouvez ensuite lancer un modèle dans le conteneur :
docker exec -it ollama ollama run qwen3.8
Télécharger le modèle et régler le contexte
Téléchargez d’abord le modèle, puis ouvrez une session de discussion dans le terminal :
ollama pull qwen3.8
ollama run qwen3.8
Pour Flash-Next, la page du modèle propose ollama run qwen3.8-flash-next:125b-mlx, une étiquette au format MLX. D’après ses notes de version, Ollama 0.40.16 réduit justement la mémoire de ce modèle sur Apple silicon. La bibliothèque liste aussi des étiquettes sans mention MLX, comme qwen3.8-flash-next:125b-a6b-q4_K_M.
Selon sa fiche, ce modèle réfléchit avant de répondre par défaut, avec une profondeur réglable par reasoning_effort (low, medium ou xhigh).
Réglez ensuite la longueur de contexte. Selon la documentation d’Ollama sur le contexte, le contexte par défaut dépend de la mémoire graphique : 4 000 jetons sous 24 Gio, 32 000 entre 24 et 48 Gio, 256 000 au-delà.
Selon Ollama, les agents et les outils de code demandent au moins 64 000 jetons. Vous pouvez imposer cette valeur au lancement du serveur :
OLLAMA_CONTEXT_LENGTH=64000 ollama serve
Si Ollama tourne en service systemd, ajoutez plutôt Environment="OLLAMA_CONTEXT_LENGTH=64000" avec systemctl edit ollama.service, comme pour OLLAMA_HOST plus bas. Dans l’application Ollama, un curseur des réglages fait la même chose.
Un contexte plus long consomme davantage de mémoire. Contrôlez ensuite avec ollama ps que la colonne PROCESSOR indique 100% GPU. Pour de bonnes performances, Ollama recommande d’éviter qu’une partie du modèle soit déchargée sur le processeur.
Interroger l’API locale d’Ollama
Ollama sert une API sur http://localhost:11434. Un appel de base ressemble à ceci :
curl http://localhost:11434/api/chat -d '{
  "model": "qwen3.8",
  "messages": [{"role": "user", "content": "Bonjour"}]
}'
Ollama implémente aussi une partie de l’API d’OpenAI, à l’adresse http://localhost:11434/v1/. Selon sa documentation, un client OpenAI existant fonctionne en changeant l’URL de base. La bibliothèque exige une clé, mais Ollama l’ignore en local : une valeur quelconque comme ollama suffit.
Par défaut, le serveur n’écoute que sur 127.0.0.1, donc sur la machine locale. Pour l’ouvrir au réseau, la FAQ indique de définir OLLAMA_HOST=0.0.0.0:11434, par exemple avec systemctl edit ollama.service sous Linux. Comme la clé est ignorée, n’importe quel poste qui atteint ce port peut utiliser vos modèles : réservez cette ouverture à un réseau privé ou à un VPN.
Brancher Qwen à Claude Code, Codex ou OpenCode
Depuis le dossier de votre projet, la commande ollama launch démarre un agent de code déjà relié au modèle choisi. Ollama propose d’installer Claude Code ou OpenCode s’ils manquent. Codex CLI doit être installé avant.
ollama launch claude --model qwen3.8
ollama launch opencode --model qwen3.8
ollama launch codex
Pour installer l’agent d’Anthropic vous-même, consultez notre article sur l’installation de Claude Code. Sans ollama launch, Claude Code peut aussi viser Ollama avec trois variables, d’après la documentation d’Ollama :
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
claude --model qwen3.8
Côté OpenAI, Codex accepte aussi codex --oss -m qwen3.8. Pour configurer Codex avec un compte OpenAI à côté de ce mode local, consultez notre article sur Codex CLI et GPT-6.2. Dans tous les cas, la documentation d’Ollama recommande un contexte d’au moins 64 000 jetons pour ces agents.
Limites et points de vigilance
La mémoire réelle dépasse la taille du fichier
Dans le ticket GitHub #19757, ouvert le 18 novembre 2026 et toujours ouvert au 20 novembre, un utilisateur décrit qwen3.8:27b sur un Mac doté de 24 Go de mémoire unifiée, avec Ollama 0.40.16 et un contexte de 16 384 jetons. Seules 56 des 66 couches tiennent sur le GPU, le processus monte à 21 Go et la pression mémoire du système devient critique dès les premières requêtes. Sur un Mac de 24 Go, ce modèle est donc à la limite, même avec un contexte quatre fois plus court que les 64 000 jetons recommandés pour un agent.
La vitesse chute avec plusieurs sessions
Dans le ticket #19767, un autre utilisateur fait tourner sous Linux, sur une carte NVIDIA L4, une version GGUF Q4_K_M de Qwen3.8-27B publiée par Unsloth et importée dans Ollama. Avec deux sessions d’agent en même temps, chaque requête relit le contexte depuis le début et le premier octet arrive après environ 46 secondes. Avec OLLAMA_NUM_PARALLEL=2 et un contexte de 16 384 jetons, il mesure environ 1 seconde.
Si vous ouvrez plusieurs sessions, réglez donc OLLAMA_NUM_PARALLEL. La contrepartie est en mémoire : selon la FAQ d’Ollama, la mémoire nécessaire croît avec le nombre de requêtes parallèles multiplié par la longueur de contexte. Ce ne sont que deux signalements d’utilisateurs, pas des mesures de référence.
Les licences ne sont pas les mêmes
Qwen3.8-27B est sous Apache 2.0. Qwen3.8-Flash-Next est sous Qwen Community License 1.0. Elle impose d’afficher le nom du modèle dans l’interface d’un produit commercial qui dépasse 100 millions d’utilisateurs actifs mensuels ou 20 millions de dollars de revenus mensuels.
Elle impose aussi une licence séparée à toute entreprise qui exerce une activité de type « Model as a Service » ou d’assistant IA au travail, pour tout usage commercial du modèle. Seul l’usage interne qui ne rend ni le modèle ni ses résultats accessibles à des tiers y échappe.
L’écart avec les modèles en ligne
Selon l’équipe Qwen, Qwen4-Max compte 2 400 milliards de paramètres. Les deux modèles présentés ici comptent au plus 125 milliards de paramètres, et aucun n’est un Qwen 4. Les scores publiés par l’équipe Qwen sur la fiche de Flash-Next (62,5 sur SWE-bench Pro, contre 61,7 pour le 27B) sont des chiffres de l’éditeur.
Côté mesures indépendantes, The New Stack a comparé Qwen4-Max et Claude Opus 5.5 le 18 novembre 2026 sur trois tâches d’agent exécutées une seule fois. Qwen4-Max y obtient 170 points sur 183 contre 179 pour Opus, pour environ un tiers du coût, mais avec un temps total environ 3,14 fois plus long. Ce test porte sur la version en ligne : il ne dit rien des petits modèles locaux à venir.
Les modèles « cloud » d’Ollama ne sont pas locaux
Ollama propose aussi des modèles « cloud », utilisables sans téléchargement. Dans sa documentation, leurs noms se terminent par :cloud ou -cloud, par exemple gemma4:cloud ou gpt-oss:120b-cloud.
Ils demandent une connexion à un compte Ollama. La recherche web proposée aux agents passe elle aussi par ce service, après ollama signin. Si l’objectif est de garder le code sur votre machine, n’utilisez que des modèles téléchargés.
Pour qui, pour quoi ?
Un modèle local avec Ollama est utile si votre code ne doit pas quitter votre machine. Il convient aussi pour travailler hors ligne, ou pour éviter de payer chaque jeton sur des tâches répétitives : génération de tests, explications de code, scripts.
Côté matériel, qwen3.8 en 27B est le point d’entrée : 18 Go de fichier, plus la mémoire du contexte. Pour un agent de code, Ollama recommande au moins 64 000 jetons de contexte, ce qui ajoute de la mémoire. Sur 24 Go, la marge est donc faible, comme le montre le ticket #19757 : prévoyez davantage si l’agent est votre usage principal.
Pour du travail d’agent sur un gros dépôt, ou si vous avez besoin des capacités de Qwen4-Max, le local ne suffit pas aujourd’hui. Il faut alors passer par l’API de QwenCloud ou par un autre modèle en ligne. Nos autres articles sur les assistants de code sont dans la rubrique Agents IA.
Questions fréquentes
Peut-on utiliser Qwen 4 avec Ollama ?
Pas au 20 novembre 2026. Qwen4-Max n’est proposé qu’en ligne, sur QwenCloud et dans les applications QwenWork, Qoder et QwenStudio, et la bibliothèque d’Ollama ne contient aucun modèle qwen4. Le modèle le plus proche est qwen3.8-flash-next, que l’équipe Qwen présente comme un aperçu de l’architecture Qwen 4.
Qwen 4 27B existe-t-il ?
Aucun modèle Qwen 4 27B n’a été publié par l’organisation Qwen sur Hugging Face au 20 novembre 2026. Les dépôts « Qwen4-27B » visibles sur la plateforme viennent de comptes tiers. Pour un modèle de cette taille aujourd’hui, prenez qwen3.8, dont la version par défaut pèse 18 Go.
Comment lancer Ollama avec Docker et un GPU NVIDIA ?
Installez d’abord le NVIDIA Container Toolkit sur l’hôte, puis lancez docker run -d --gpus=all -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama. Le modèle se télécharge ensuite avec docker exec -it ollama ollama run qwen3.8.
Un LLM local fonctionne-t-il sans carte graphique ?
Oui, Ollama sait tourner sur le seul processeur, y compris dans Docker. Le modèle est alors chargé en mémoire système, ce que ollama ps affiche comme 100% CPU. Ollama recommande d’éviter ce mode quand la performance compte.